AI 工程里那些被我跳过的基础
从 Token 编码、RAG 排查到 Agent 的上下文、状态与预算,重新梳理那些容易被跳过、却决定 AI 应用能否可靠交付的工程基础。
这几天看 AI 工程相关的东西,我慢慢意识到一个之前被自己忽略的问题:我们这一批做 AI 开发的人,很可能省略了太多底层原理,直接冲到了应用层。
现在刷技术社区,满眼都是 Agent、MCP、RAG、Skill 和各种自动化框架。会用 Codex,懂一点 API,哪怕代码写得不多,也能很快拼出一个看上去挺复杂的 AI 应用。
但有个很基础的问题,我以前也没认真想过:当我们把一段 Prompt 发给大模型时,模型实际处理的到底是什么?
对常见的文本大模型来说,文本会先经过 Tokenizer,切成 token,再映射为 token ID 序列,进入模型后转换为内部的向量表示。仅仅是前面的切分和编号,就已经和我们平时理解的“几个字、几句话”不一样了。不同 tokenizer 的切分方式也可能不同。关于 token 和 ID 的对应关系,可以直接看 Hugging Face 的 Tokenizer 示例↗。
这些看起来很基础的细节,和上下文预算、API 成本、知识库切分,以及 Agent 跑长任务时的稳定性都有关系。
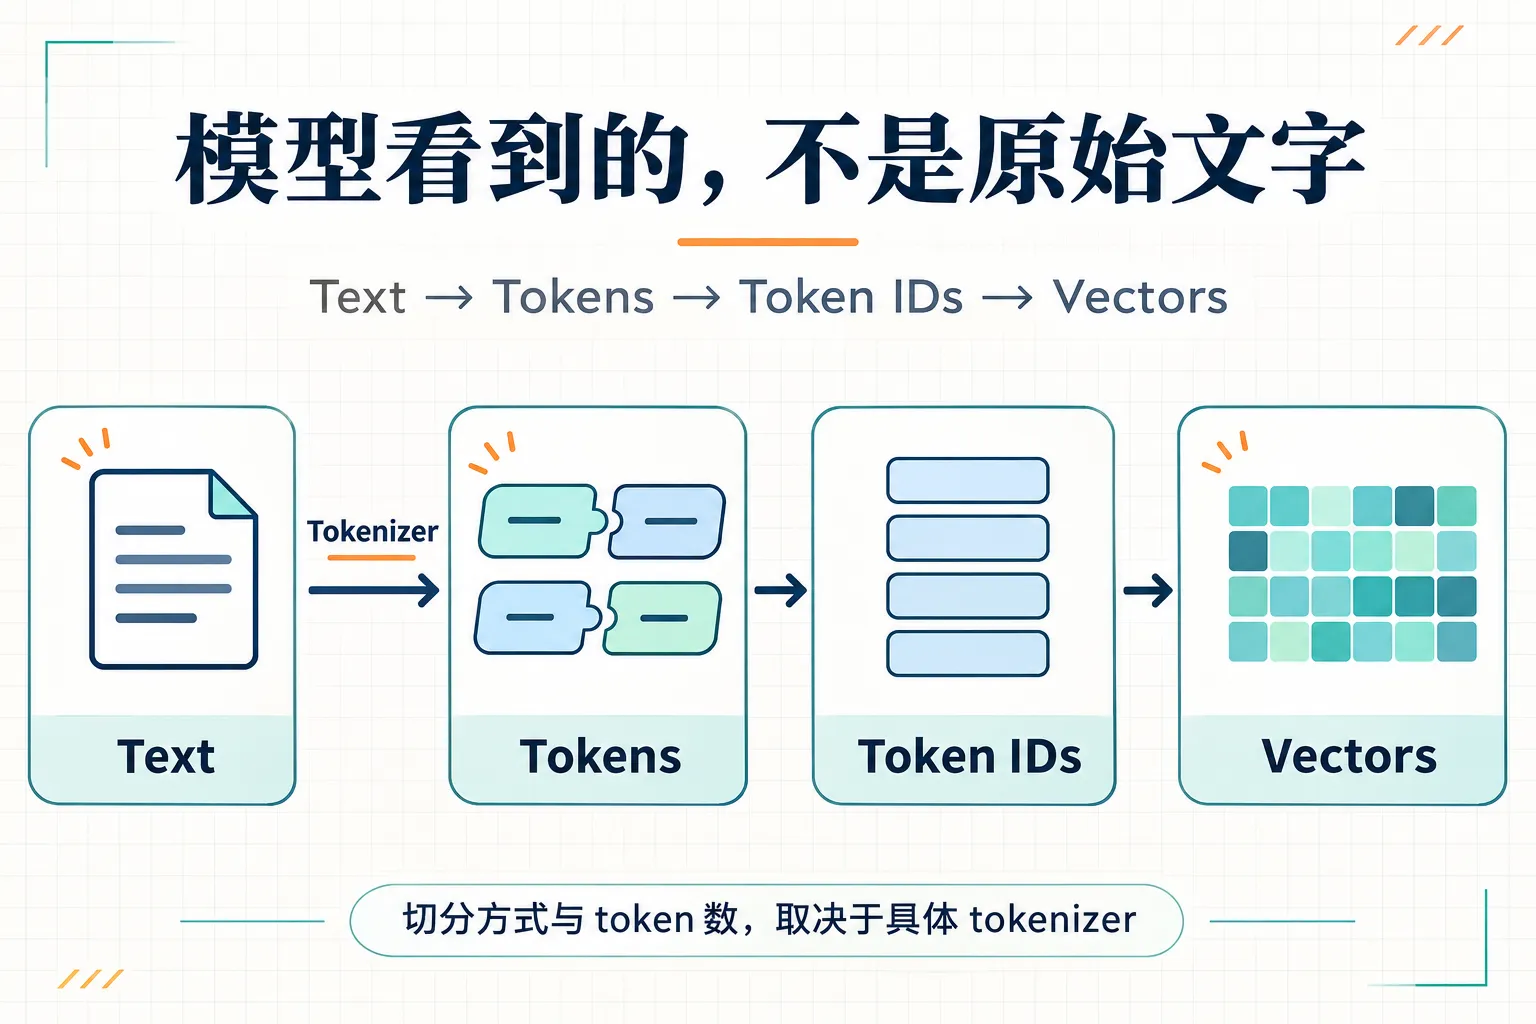
图 1:文本进入模型的简化路径。实际切分方式与 token 数取决于具体 tokenizer。
我最近在做企业 AI 落地,涉及 GEO、知识库、Agent 和自动化工作流。越往后做越发现,这些问题根本绕不开。
一 答案在文档里,模型为什么还是答不出来
拿一个很常见的场景说。
企业给你几百份文档,让你搭一个知识库问答应用。你把文档导进去,切成 chunk,生成 embedding,再接上大模型。流程跑通了,演示效果看着也挺顺。
但客户真正用起来,可能会突然问:答案明明就在文档里,为什么 AI 就是答不出来?
很多人的下意识判断是:模型不够强,Prompt 没写好,或者是不是该换个更厉害的 Reranker。
可在这些判断之前,至少有几件事要先查清楚。
比如,你按字符数硬切文档,却没检查向量模型实际接收的 token 数有没有超限。如果处理链路配置了截断,部分内容可能在生成 embedding 前就丢掉了;如果接口不接受超长输入,请求也可能直接失败。截断不是所有模型和接口的默认行为,具体要看所用的 tokenizer、模型和调用配置。可以对照 Hugging Face 的截断设置↗和 OpenAI Embeddings 的输入限制↗检查自己的链路。
又比如,切分时把一个完整业务链路切碎了,检索出来的片段缺少必要上下文。再比如,答案所在的片段压根没被检索到,生成模型从头到尾都没看到正确依据。
你以为是 AI 不够聪明,实际上可能是整条链路没有把正确信息交到它手里。
所以,RAG 出问题,应该分层看:
- 入库:文档是否解析完整,切分后有没有丢失内容?
- 召回:包含答案的片段有没有被检索到?
- 重排:如果使用了重排,正确片段有没有被保留下来?
- 上下文:最终送进模型的内容是否完整,能不能装得下?
- 生成:模型有没有依据这些内容作答?
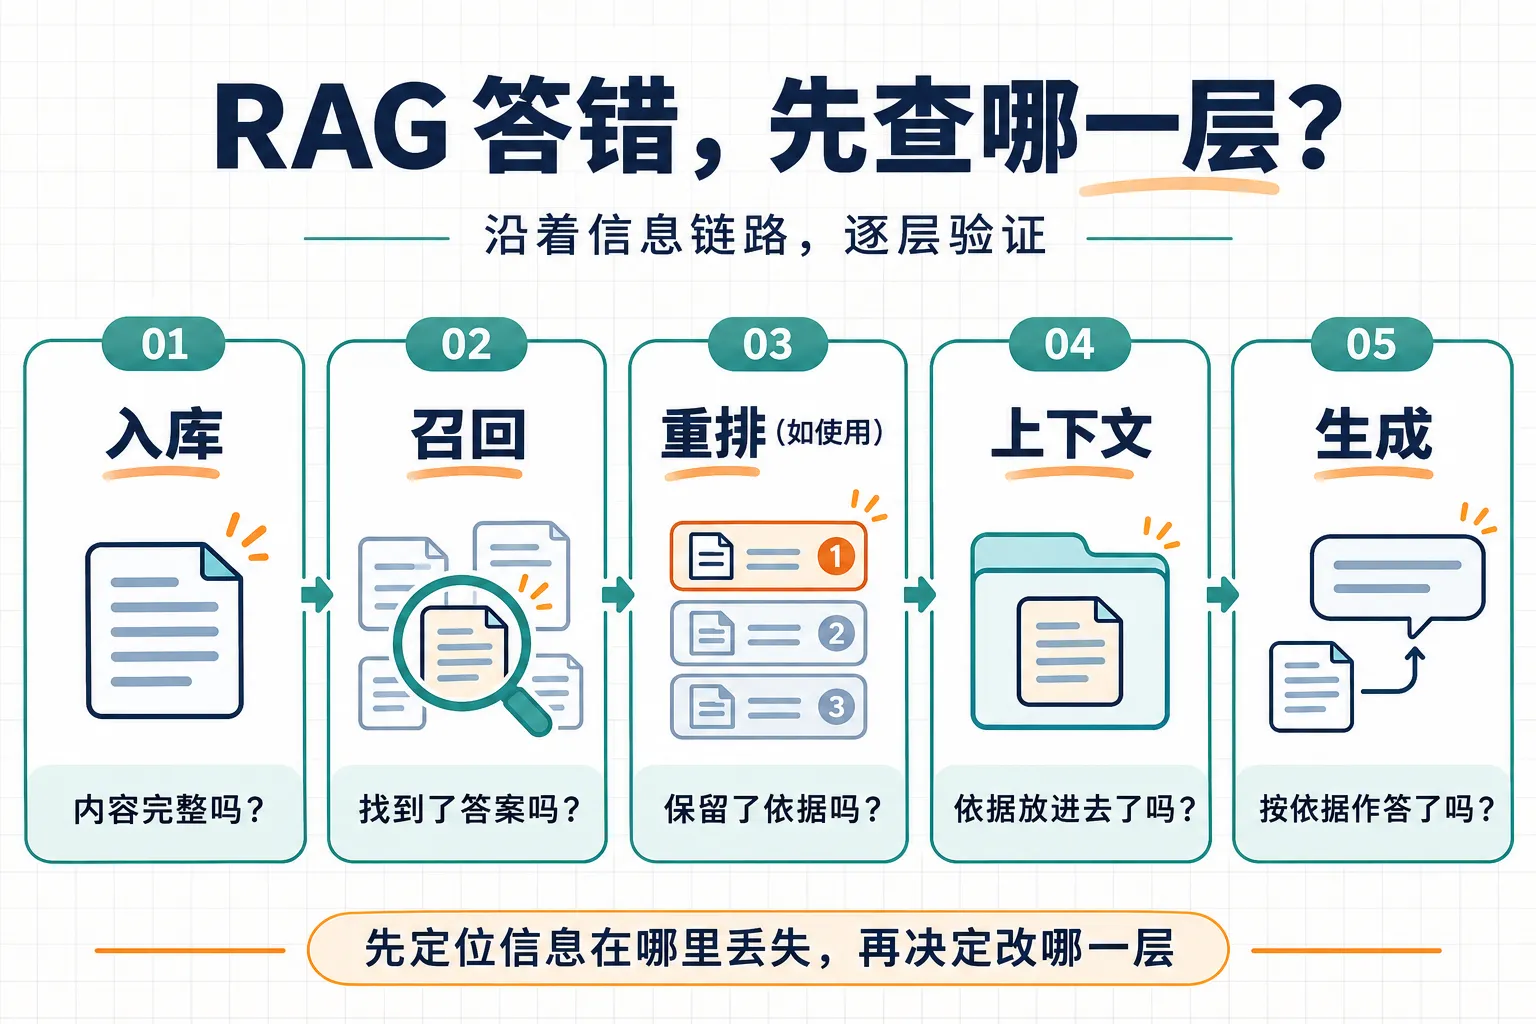
图 2:先沿信息链路逐层验证,再判断该改哪一层;重排并非所有 RAG 的必选环节。
不拆开排查,换模型和改 Prompt 很容易变成盲修。
二 Agent 出问题,也不能只盯着 Prompt
Agent 也一样。
一个 Agent 要完成复杂任务,一次任务里可能反复调用十几次工具。工具会带回 JSON、运行日志、数据库查询结果。如果这些信息不加筛选地堆进上下文,token 消耗会越来越大,真正重要的内容也可能被噪声淹没。
最后,Agent 开始出现各种奇怪表现:漏掉约束,重复调用同一个工具,忘记前面设过的条件,甚至因为上下文超限而失败。
这些表现未必都由上下文造成,但如果不检查上下文是怎么组织的,只修改 Prompt,就可能一直没碰到真正的问题。
我更想追问的是:信息在整条链路里怎么走?哪些内容被留下,哪些被压缩,哪些被丢掉?下一步执行时,Agent 还能不能拿到需要的状态?
从工程实现上,我更愿意把 Agent 看成一个带预算的状态机。工具返回不能无脑塞进上下文,要裁掉无关字段,必要时做结构化摘要,把需要长期保存的状态放到上下文之外,再按需读取。这些也是上下文工程里常见的做法↗。
同时,还要设好 token、耗时和调用次数的预算,考虑超时和重试上限。涉及写入或外部操作时,要用幂等设计避免重试造成重复执行,并留下能还原过程的 trace。
否则任务一复杂,出了问题就很难查。
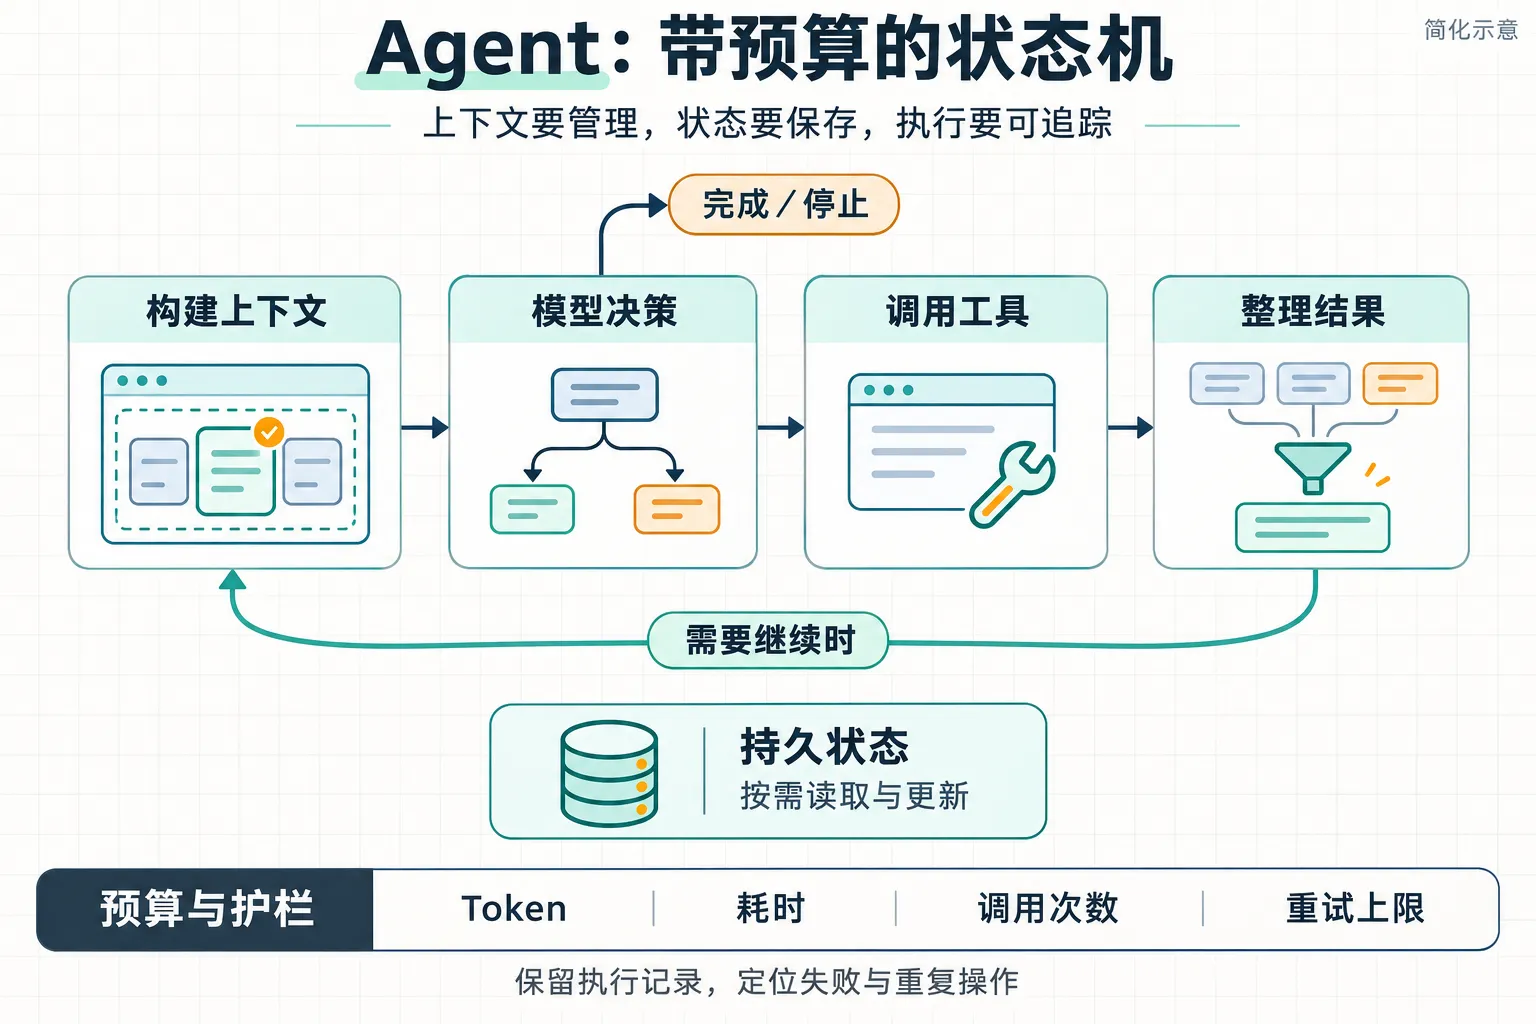
图 3:把 Agent 理解为带预算的状态机。图为简化示意,具体实现会因任务而异。
三 AI 工程的核心,是让信息流可验证
所以,我现在对 AI Engineering 有了一个新的理解:要保证正确的数据,在需要的时候,以合适的形式进入模型,还要让整条链路的行为能看见、能验证、能修。
这话听起来不复杂,但真做起来,要补的东西很多。
你要理解 Tokenization,知道输入会怎样被编码,token 数该怎么计算。
你要理解 Context Window,知道系统指令、历史对话、检索结果和工具返回分别占了多少预算,也要按模型的规则给生成输出留出空间。
你要理解 RAG 的切分、召回和重排,能区分“没有检索到答案”和“模型拿到依据后仍然答错”。
你还要理解 API、异步任务、状态管理、幂等性、重试机制,以及失败之后怎么恢复。
这些知识单拎出来,可能都没有一个新 Agent 框架吸引眼球。但应用真正进企业、处理真实业务时,决定它能不能长期跑的,恰恰是这些不起眼的工程细节。
AI 编程工具确实强。你提需求,模型帮你生成代码、装依赖、接 API,甚至自动部署。页面出来了,接口通了,功能也能演示,很容易让人产生一种感觉:这个应用我已经会做了。
可再往下问:为什么选这种切分方式?为什么这次检索失败?为什么 Agent 成本突然涨了?为什么任务重试后出现重复执行?自己不一定答得清楚。
从让 AI 帮我写出一个能跑的应用,到真正能设计、诊断和维护它,中间还有不少功课要补。
四 我准备换一种学习方式
我并不打算因此回到从零手写所有东西。相反,还是应该尽量用 AI 提高开发效率,把省下来的时间拿去理解架构、分析问题、补真正重要的工程知识。
写代码的门槛和成本在下降,真正稀缺的,可能变成了判断该写什么、不该写什么,以及出问题后怎么定位、怎么修。
接下来,我准备少追一点新框架,把现有项目往深里挖。
- 统计知识库里每个 chunk 实际占多少 token,测试不同切分策略对检索效果的影响。
- 记录 Agent 每一步的 token 开销、耗时和工具返回,看看成本和时间到底花在哪里。
- 一次回答错了,就按数据、检索、上下文、生成几层去拆,定位具体是哪一步出了问题。
这些事没有做一个炫酷 AI Demo 那么容易获得关注,但我觉得它们更接近真正的工程能力。
尤其对想做 FDE、AI Engineer 的人来说,最后面对的是企业真实业务。客户不会因为你用了最新 Agent 框架,就接受一个经常出错的线上应用。他们关心的是问题能不能解决、成本能不能控住、故障能不能恢复,以及这套东西能不能持续创造价值。
所以,我现在最想提醒自己的,是别每天都在追新东西,却始终没把真正重要的基础打牢。
未来 AI 工程师之间的差距,可能会越来越体现在:谁能解释清楚一个应用为什么能跑,又为什么会失败,并且有能力把问题解决。
会使用 AI,正在变成越来越普遍的能力。能理解一条 AI 链路、把它调稳,并可靠地交付到真实业务里,才是我真正想积累的能力。